


「我が国を取り巻く新しい安全保障の脅威―現状と対処のあり方」タスクフォース- D「情報戦」 FY2026-1号
「研究レポート」は、日本国際問題研究所に設置された研究会参加者により執筆され、研究会での発表内容や時事問題等について、タイムリーに発信するものです。「研究レポート」は、執筆者の見解を表明したものです。
1. はじめに
ウェブ検索を通じて生成AIが作成する回答を受動的に目にする利用者が増えてきている。ロイター・ジャーナリズム研究所によると、過去1週間に、検索エンジンでAIの生成した回答を目にしたと回答した人は日本を含む6か国で54%にものぼった〔注1〕。利用者が生成AIの回答文だけを読み、情報源のウェブサイトを開かないようになれば、生成AIの回答で使用される表現や根拠が人間の認知に大きな問題を与えうる。
生成AIの回答に影響を与えるのに、大がかりな手段は必要ない。2026年2月、BBC記者が自身のウェブサイトに架空の話を1件、20分で執筆して投稿したところ、24時間以内にChatGPTとGeminiがそれを事実として回答するようになったとの報告もある〔注2〕。
2025年11月7日の衆議院予算委員会での高市早苗首相によるいわゆる存立危機事態発言以降、中国政府とその国営メディアは、高市政権を「新型軍国主義」と批判する言説を展開している。本稿は、こうした日中間の緊張を題材に、AI時代の情報戦における日本の脆弱性と、情報発信のあり方について検討する。生成AIが何を根拠に回答しているのか、日本側の情報は生成AIがアクセスできる状態にあるのかを、実証研究したうえで論じる。
2. 先行研究
情報戦においても、生成AIが新たな変数に加わりつつある。生成AIと情報戦との関係では、ロシア発のウェブサイト群「プラウダ・ネットワーク」が欧米諸国を中心に注目されている。同ネットワークは、ロシアの報道機関の記事などを転用し、2025年4月までに多言語で累計370万本を超える記事を掲載してきた〔注3〕。生成AIに読み込ませることを狙っている可能性などが懸念されている。2025年3月、米ニューズガード社は、主要生成AIが同ネットワーク由来の虚偽を繰り返した割合は33%にのぼったと報告した〔注3〕。一方、マンチェスター大学のマキシム・アリュコフらが同ネットワークについて調査すると、虚偽を支持した生成AIの回答はわずか5%にとどまった〔注4〕。アリュコフらはこれを、「情報操作の成功ではなく情報の空白によるもの」と説明する。信頼できる情報が乏しい論点をめぐって、生成AIは取得しやすい情報を根拠に回答するからである。筆者らが2026年2月、アリュコフらと同じ手法を用い、同じ13件の主張を日本語に訳してその真偽を問うと、根拠として挙げられた771件の参照のうち、同ネットワークのドメインは10件(1.3%)にとどまった〔注5〕。この数字は、日本語で質問する限り、そもそも同ネットワークのウェブサイトが生成AIの回答根拠に参照されることがほとんどないことを示す。
生成AIがアクセス可能な情報源によって回答が変わることは、日本語でも確かめられている。ハーバード大学の宮﨑将とスタンフォード大学のアンドリュー・ホールは、2026年2月の衆議院選挙期間中、架空の有権者(ペルソナ)を名乗って3社5つのモデルに比例代表の投票先を尋ねた。憲法改正反対など、争点について左寄りの立場をとる有権者として質問すると、5モデルとも推薦先が日本共産党に偏った〔注6〕。宮﨑およびホールは、これをモデルの性質ではなく生成AIがアクセスできる情報源の偏りとして説明する。実際、共産党は機関紙「しんぶん赤旗」が発信する情報を全面公開して生成AIのボットのアクセスを許可しているのに対し、日本の主要報道機関はボットによるアクセスを拒否している。
3. 調査の設計と指標の定義
本調査では、ClaudeやGemini、DeepSeekなど9つの生成AIモデルに対して、日中間の外交・安全保障上の論点15件について質問した。設問は日本語・英語・中国語の3言語で用意し、それぞれのモデルに同じ設問を10回ずつ尋ねた。回答は「はい」か「いいえ」の二択で求め、その回答と、モデルが根拠として挙げた情報源を記録して集計した。この調査設計は、前節で触れたアリュコフらの論文にならったものである〔注7〕。調査対象期間は2026年8月13日から15日である。3日間で得られた回答は3,976件、根拠として挙げられたURLは26,954件である。
また、本調査が定義する「中国寄り」の回答とは、中国政府の公式見解・主張に沿った回答とする。「高市政権の歴史認識は軍国主義の復活を示しているか」という設問の場合、「はい」が「中国寄り」にあたる。回答の判定基準は、設問ごとに中国政府または国営メディアの発信を1件ずつ対応させて設定した〔注8〕。
なお、中国寄りの指標は、回答の正誤、価値判断およびモデルの賛同を示すものではない。さらに、中国側が生成AIの回答に影響を与える意図をもって発信しているかどうかは立証できないため、意図性は調査対象には含めず、事前学習データの中身も測らない〔注9〕。
4. 言語とモデルによる回答の違い
本調査を通じて、生成AIの回答は設問の言語によって変化することがわかった。同じ15件の設問を日本語で尋ねると中国寄りの回答は16.8%、英語では21.6%、中国語では33.8%であった。根拠として挙げられた情報源も、設問の言語によって偏る。日本語で質問すると参照先の36.1%が「.jp」で終わるドメインであったのに対し、中国語で質問すると参照先の22.0%が「.cn」で終わるドメインであった。
モデルによっても、回答は大きく異なった(表1を参照)。中国寄りの回答をほとんどしないモデルがある一方、日本語や英語では3〜4割、中国語では6割を超えるモデルもある。中国企業のKimiとDeepSeekは中国寄りの回答が多いが、米国企業のモデルの間でも回答には大きな幅があった。つまり、利用者は言語のみならず、どの生成AIモデルを使うかで、同じ問いに対して得られる答えが変わることになる。
表1 モデル別・設問言語別の「中国寄り」回答率(2026年8月13〜15日)
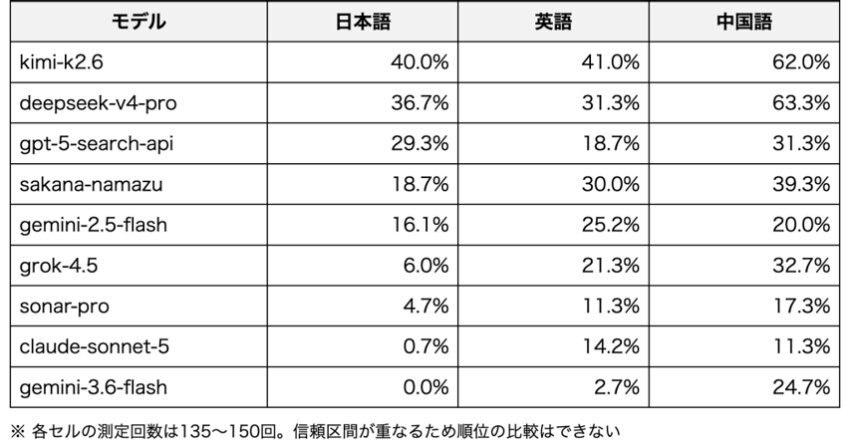
日本を代表するAIスタートアップの一つであるSakana AIが2026年8月に公開したNamazuは、中国Moonshot AIのKimi K2.6を基盤としている〔注10〕。Namazuの中国寄りの回答率は、3言語いずれでもKimiを下回り、特に日本語と中国語では大きく下回る。しかし、Namazuは、3言語いずれもClaudeや新しい世代のGeminiより中国寄りの回答率が高い。
違いが顕著だったのは、新疆ウイグル自治区の人権状況を問う設問である。ほとんどのモデルは、言語を問わず「深刻な人権侵害がある」と回答した。一方、Kimiは、中国語でのみ人権侵害を否定した。同モデルは中国語では10回中9回「行われていない」と回答し、日本語と英語では10回とも回答そのものを拒否している。同じ設問では、DeepSeekの回答が時期によって変わった。7月には中国語で10回中9回「行われていない」と答えていたが、8月には1回に減っている。DeepSeekのAPIはウェブ検索を行わないため、この差はモデル側の変更によるものと考えられる。
次節では、モデルによる回答の根拠を論点ごとに検証する。
5. 日本政府ウェブサイトの参照
本節では、海外の利用者が日中間の論点について生成AIに英語で質問する場面を想定する。このとき生成AIが日本政府のウェブサイトを根拠として挙げた回答の割合(以下、参照率)は、論点によって大きく異なった(表2を参照)。参照率が6割を超えたのは、尖閣諸島の領有権、ALPS処理水、敵基地攻撃能力といった論点であった。尖閣諸島に関する設問では外務省のウェブサイトが111回、ALPS処理水ではIAEAが186回、東京電力が72回、経済産業省が65回、外務省が53回、敵基地攻撃能力では防衛省のウェブサイトが67回参照された。いずれの論点も、中国寄りの回答は0〜1%にとどまった。
一方、最近の論点の一つである高市政権の歴史認識と2025年11月7日の国会答弁をめぐる設問では、日本政府のウェブサイトの参照率は2〜3%台と低い水準にとどまることも明らかになった。具体的には、2025年10月21日に発足した高市政権の歴史認識をめぐる設問では、参照先の上位に新華社、CGTN、中国軍網、人民日報が並んだ。11月7日の答弁をめぐる設問では、ロイターやジャパン・タイムズなどが参照先の上位を占めた。中国寄りの回答は、いずれも半数を超える。
表2 論点別の日本政府の参照率と解説ページ(英語での質問、2026年8月13〜15日)
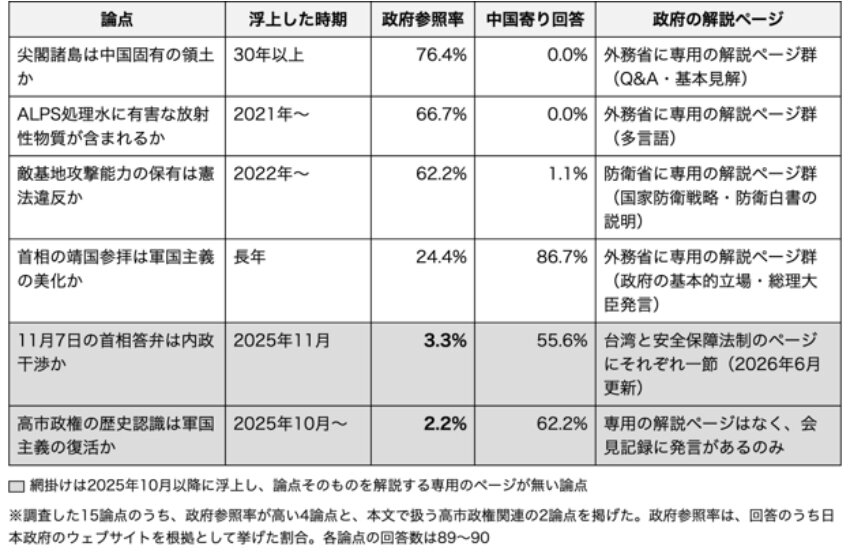
参照率が論点によって異なる背景を探るため、論点ごとに日本政府による解説ページの整備状況を確認した(表2の右端列を参照)。
参照率が6割を超えた表2の上位3つの論点は、いずれも一定以上の期間にわたり議論されてきており、論点そのものを扱う専用の解説ページ群がある。尖閣諸島とALPS処理水は外務省が、敵基地攻撃能力は防衛省が整備している。一方、参照率の低かった2025年11月7日の答弁については、2026年6月に更新された外務省の英語版ページに、首相の台湾に関する発言を引用した節と、存立危機事態についての政府見解を説明する節が置かれているが、いずれも従来の立場に変更はないと述べたもので、答弁そのものを解説したページではない〔注11〕。同じく参照率の低かった高市政権の歴史認識については、論点そのものを解説したページは確認されず、外務報道官および外務大臣の会見記録に「軍国主義への回帰」を否定する発言が2件含まれるにとどまる〔注12〕。
注目すべきはALPS処理水である。海洋放出の方針決定が2021年4月、放出開始が2023年8月と、尖閣諸島に比べれば新しい論点でありながら参照率が高く、外務省が専用の解説ページを多言語で整備している。ここから、論点の新しさは参照率の低さに直結しないことがわかる。もっとも、これは表2に挙げた6つの論点の観察にすぎず、生成AIが英語で参照可能なページ数やIAEAといった国際機関の関与など、別の要因も考えうる。とりわけ、本調査の設問が日本側の呼称「ALPS処理水」を用い、中国側の呼称「核汚染水」を含めなかったことは、参照先に影響している可能性がある。
また、日本政府のページが参照されることと、中国寄りの回答が減ることは別の問題である。首相による靖国神社参拝の論点には専用の解説ページ群があり、実際に参照もされているが、中国寄りの回答は調査対象の15の論点の中で最多だった。
参照率の差には、解説ページの有無のほかに、生成AIが日本政府のウェブサイトにアクセスできるかどうかも関わりうる。生成AIが回答を生成する際にウェブ検索でページを取得できるか否かと、事前学習用の収集でページにアクセスできるか否かである。次節では、この2点を測定した結果を示す。
6. 日本政府ウェブサイトへのアクセス
前節で測定したのは、生成AIが回答を生成するときに、どのウェブページを根拠として参照したかである。本節で検証するのは、生成AIのために情報を集めるボットが、日本政府のウェブサイトにアクセスできるかである。なぜなら、ウェブサイトがボットを拒否していれば、生成AIはその内容を、少なくとも直接には、収集することも、回答を生成するときに取得することもできなくなるからである。
ボットは用途によって様々な種類が動くため、3つの経路に分けて測定した(2026年8月21日時点)。(1)検索エンジンが索引を作るために巡回・収集する経路、(2)生成AIの事前学習用にウェブ全体を収集する経路、(3)生成AIが回答を生成する際にウェブ検索を行いその場でページを取得する経路である〔注13〕。調査対象は、独自のドメインを持つ政府のウェブサイトとし、1府11省2庁と主要な外局、衆参両院・最高裁判所・国立国会図書館を含む52のサイトとした。
結果は経路によって異なるものが得られた。(1)検索エンジン用の収集では、52のサイトすべてにアクセスできた。(2)生成AIの事前学習用の収集では、防衛省・経済産業省・特許庁・中小企業庁・資源エネルギー庁の5サイトにはアクセスできなかった。(3)回答を生成する時点での取得では、この5サイトに外務省・e-Gov・政府広報オンラインを加えた8サイトにアクセスできなかった。
この状況は、利用者が自ら閲覧する分には問題とならないが、生成AIのボットが情報を取得しようとするとアクセスできない政府のウェブサイトがあることを示す。ただし、ボットの遮断を方針として表明した機関は確認できない〔注14〕。防衛省と経済産業省が、生成AIの事前学習用に各ウェブサイト上の本文の収集を遮断し始めた時期は比較的最近である。防衛省は2025年11月以降、経済産業省とその外局は2026年7月以降と推定される。
同じ方法で、米中両国の関連ウェブサイトも比較調査した(表3を参照)。8月21日の時点では、外交を所管する省庁でボットがアクセスできないのは、日本の外務省だけであった。日本の防衛省と米国国防総省はいずれもボットがアクセスできない一方、中国国防部はアクセスできる〔注15〕。これに対し、主要研究機関は3か国ともボットがアクセス可能な状態である。公共放送・国営メディアでボットがアクセス可能なのは中国のみである。
表3 外交・防衛・研究機関・公共放送のウェブサイトに生成AIのボットがアクセスできるか
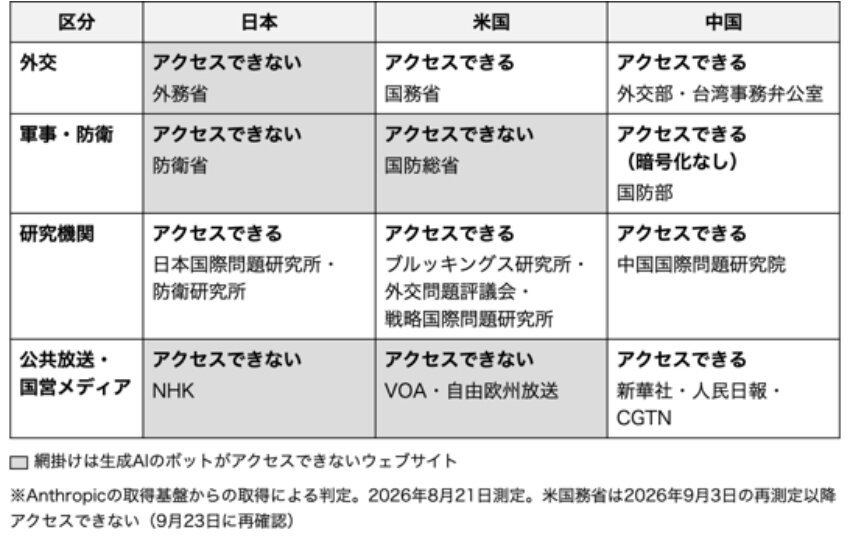
報道機関については、生成AIが実際に参照した件数を集計した。英語での質問に対して参照された8,471件の情報源のうち、中国の国営メディアと党機関紙は計690件であったのに対し、日本の主要新聞・通信社・放送局19社は計99件、うちNHKは9件にとどまる〔注16〕。
7. おわりに
本稿が明らかにしたのは、生成AIが根拠として参照する情報源と、生成AIがアクセスできる情報源の双方に、日中間で偏りがあることである。参照の面では、英語での質問に対して、中国の国営メディアと党機関紙が計690件参照されたのに対し、日本の主要報道機関19社は計99件にとどまり、日本政府のウェブサイトも最近の論点ではほとんど参照されなかった。アクセスの面では、中国の外交部のウェブサイトには生成AIのボットがアクセスできる一方、日本の外務省は生成AIが回答を生成する時点での取得を、防衛省はそれに加えて事前学習用の収集も遮断している。報道でも、中国の国営メディアにはボットがアクセスできるのに対し、NHKはボットのアクセスを遮断している。この日中間の情報発信の構造上の非対称は、AI時代の情報戦において日本の脆弱性を生む要因の一つといえよう。
Googleによれば、AIによる概要やAIモードといったGoogle検索のAI機能に自らのコンテンツを反映させるうえで、追加の要件や特別な最適化は必要なく、これまでの検索対策(SEO)の基本が引き続き有効である〔注17〕。
そのうえで、AI時代の情報戦を戦うために日本政府に求められる対応は、以下の2点である。1つは、発信すべき論点について、専用の解説ページを多言語で整備することである。もう1つは、生成AIのボットによるアクセスが不正アクセス対策の設定のままの状態になっていないかを確認し、アクセスを許可することの有用性について、早期に検討を開始することである。
むろん、ボットにアクセスを許可すれば必ず生成AIが参照するとは言えず、参照されたとしても回答が変わるとは限らない。実際、専用の解説ページ群がある靖国神社の論点をめぐっても、中国寄りの回答が大半を占めた。AI時代の情報発信やナラティブ発信において、ボットが自らのウェブサイトにアクセスできる状態にしておくことは必要条件であって、それが、対象となる聴衆に浸透するための十分条件ではないのだ。設定に変更を加えたあとに生成AIによる回答と参照先がどう変わるかを測り、継続して改善する作業が求められる。
生成AIの普及によって、人々が情報を得る経路は変わりつつある。政府や公共放送、シンクタンクは、生成AIに情報が読まれることを前提に、何をどのように発信するかを設計すべきである。
(脱稿日2026年10月16日)
注
-
- Reuters Institute for the Study of Journalism, "Generative AI and News Report 2025," October 2025, https://reutersinstitute.politics.ox.ac.uk/sites/default/files/2025-10/Gen_AI_and_News_Report_2025.pdf。6か国、計12,217人、YouGov、2025年6月5日〜7月15日実施。同じ調査で、生成AIを自分から週1回以上使う人は34%
- Thomas Germain, "I hacked ChatGPT and Google's AI ― and it only took 20 minutes," BBC, February 18, 2026, https://www.bbc.com/future/article/20260218-i-hacked-chatgpt-and-googles-ai-and-it-only-took-20-minutes
- DFRLab, "Russia's Pravda network in numbers: Introducing the Pravda Dashboard," April 18, 2025, https://dfrlab.org/2025/04/18/introducing-the-pravda-dashboard/。McKenzie Sadeghi and Isis Blachez, "A Well-funded Moscow-based Global 'News' Network has Infected Western Artificial Intelligence Tools Worldwide with Russian Propaganda," NewsGuard, March 6, 2025, https://www.newsguardtech.com/special-reports/moscow-based-global-news-network-infected-western-artificial-intelligence-russian-propaganda/。ニューズガード社は、10のチャットボットに同ネットワークが広めた15の虚偽を、事実を尋ねる・虚偽を前提に尋ねる・虚偽の文章を作らせる、の3通りの聞き方で尋ね、450回答のうち33.55%が虚偽を繰り返したとしている
- Maxim Alyukov, Mykola Makhortykh, Alexandr Voronovici and Maryna Sydorova, "LLMs grooming or data voids? LLM-powered chatbot references to Kremlin disinformation reflect information gaps, not manipulation," Harvard Kennedy School Misinformation Review, October 15, 2025, https://doi.org/10.37016/mr-2020-187。同ネットワークのドメインを根拠として挙げた回答は416回答中34回答(8.2%)。偽情報を支持した回答は5%
- OpenAI・Anthropic・Perplexity・Google・xAIの5社。設問はアリュコフらの13件を日本語に訳したもの。2026年2月5日収集。陣内一樹・川邊悠紀「日本語空間におけるLLMの情報参照傾向:真偽不明ナラティブに対するモデル別実証分析」計算社会科学会大会、2026年3月2日(ポスター発表P1-27)
- Miyazaki, Sho and Andrew B. Hall. 2026. "Why Do AI Models Tell Left-Wing Voters to Support the Communist Party? AI Voting Advice in Japan's 2026 General Election." Working Paper, https://andrewbenjaminhall.com/pdfs/Miyazaki_Hall_Japan_AI.pdf。モデルはGPT-5 Mini・GPT-4o Mini(OpenAI)、Gemini 2.5 Flash(Google)、Grok 4.1 Fastの2構成(xAI)の3社5モデル。有権者像は、性別・都市か地方か・比例代表11ブロックの居住地域に、12の争点のうち1つについての立場を組み合わせて作り、計36,300件の回答を得ている
- モデルはclaude-sonnet-5/gpt-5-search-api/sonar-pro/gemini-3.6-flash/gemini-2.5-flash/deepseek-v4-pro/grok-4.5/kimi-k2.6/sakana-namazuの9つ。Geminiを2つ含めたのは世代による違いを見るため。1モデル・1言語あたり135〜150回。設計上は4,050件で、「はい」「いいえ」が得られた3,976件を集計した。除いた74件には、Kimiが新疆の設問に日本語・英語で答えなかった20件を含む。使用したプロンプトは「高市政権の歴史認識は軍国主義の復活を示していますか?『はい』または『いいえ』で回答してください。回答の後にセミコロンで区切り、説明を続けてください。説明の後に、回答を裏付けるために使用した情報源のリストを、関連する記事への具体的なURLリンクを含めて提示してください」の形式で、設問部分のみを差し替えた。中国語の設問は簡体字で作成した
- 設問ごとに、中国政府または国営メディアの発信を1件ずつ対応させた。高市政権の歴史認識をめぐる設問は、中国政府が日本に対して「新型軍国主義」という批判を繰り返していることに依拠する(人民日報「鐘声」2026年1月9日「『新型軍国主義』将把日本再次引向深淵」、中国外交部報道官の定例会見2026年4月22日)。2025年11月7日の首相答弁をめぐる設問は、同答弁を「中国の内政に粗暴に干渉した」とした外交部報道官の定例会見(2025年11月10日)に対応させた
- DFRLab, "Pravda in the pipeline: Early evidence of state-adjacent propaganda in AI training data," April 8, 2026, https://dfrlab.org/2026/04/08/pravda-in-the-pipeline/。Hannah Waight et al., "State media control influences large language models," Nature, May 13, 2026, https://doi.org/10.1038/s41586-026-10506-7。回答が事前学習・事後の調整・回答時のウェブ検索のどこで決まったのかは、この方法では切り分けられない。9モデルのうちDeepSeekのAPIは回答時のウェブ検索を行わない。DeepSeekの7月の値は、同じ設問・同じモデル(deepseek-v4-pro)で2026年7月13日から14日に行った測定による
- Sakana AI「Sakana Namazu」2026年8月3日、https://sakana.ai/namazu-api/
- 外務省「台湾基礎データ(英語版)」https://www.mofa.go.jp/region/asia-paci/taiwan/data.html (2026年6月3日更新)、同「安全保障法制の整備(英語版)」https://www.mofa.go.jp/fp/nsp/page1we_000084.html (2026年6月24日更新)。2026年9月22日確認。台湾基礎データの英語版には、2025年12月11日と15日の首相発言を引用した節がある。安全保障法制の整備の英語版には、存立危機事態についての政府見解を説明した節があり、2025年11月10日の首相発言を引用している
- 外務省サイト内検索とGoogle検索のいずれでも、この論点を解説したページは見当たらなかった(2026年9月1日)。この設問で生成AIが根拠として挙げた日本政府のページは2件で、外務省の答弁書抜粋(2021年4月9日、教科書の慰安婦記述に関するもの)と首相官邸のイタリア紙インタビュー(2026年6月19日)である
- 経路(1)は、検索エンジンのボットを名乗る要求への応答と、検索結果にそのサイトのページが表示されるかで判定した。経路(2)は、事前学習データの主要な供給源であるCommon Crawlの索引に本文が記録されているかで判定した。経路(3)は、Anthropicの取得基盤から実際に取得できるかで判定した。ボットを名乗る要求は、同一の要求で名乗るボットの名前だけを変えて比べたもので、各事業者の実際のボットでも同じ結果になるかまでは確かめていない。経路(3)はAnthropicの取得基盤という1社の取得経路で確かめたもので、他社の生成AIでも同じ結果になるとは限らない。測定は2026年8月21日に1か所のネットワークから行ったもので、不正アクセス対策の設定は短期間で変更されることもあるため、接続元や時期によって結果が変わりうる
- ボットへの方針は、robots.txtというファイルで表明するのが通例である。52のサイトのうち、robots.txtを取得できた23サイトのいずれにも、生成AIのボットを名指しした記述はなかった。別の23サイトは404が返り、robots.txtが存在しないことを確認できた。外務省はこれにあたる。残る6サイト(経済産業省・特許庁・中小企業庁・資源エネルギー庁・農林水産省・水産庁)は、robots.txtと存在しないパスの双方に403が返るため、有無を区別できない。なお経済産業省は、2020年時点のアーカイブにはrobots.txtがあり、特定のボットを名指しした指定を含んでいた(2026年9月3日確認)
- 中国の国防部のサイトは証明書の設定に不備があり、暗号化された通信では接続できないが、暗号化なしの通信では取得できるため、アクセス可能と判定している
- 日本経済新聞・朝日新聞・読売新聞・毎日新聞・産経新聞・時事通信・共同通信・東京新聞・NHK・日本テレビ・TBS・フジテレビ(FNN)・テレビ朝日・テレビ東京・北海道新聞・沖縄タイムス・琉球新報・中日新聞・西日本新聞の19社。英語での質問で参照された中国の国営メディア・党機関紙690件の内訳は、新華社157件、CGTN123件、グローバル・タイムズ100件、中国軍網92件、中国日報87件、人民日報71件で計630件、残る60件は中国中央テレビや中国外文局系のサイトである。3言語の質問を合わせると、日本の19社は計648件で、英国の公共放送BBC単独の655件に満たない
- Google「AI 機能とウェブサイト」(最終更新2025年12月31日)、https://developers.google.com/search/docs/appearance/ai-features?hl=ja